Blog · · Lorenz
Unser eigenes KI-Modell liest Belege besser als GPT und Claude
OpenAI hat ein Modell abgeschaltet, auf das unser internes Spesen-Tool angewiesen war. Unser eigenes Modell liest auf 180 echten Belegen 96,7 % richtig und läuft dort, wo wir es betreiben wollen.
Das Wichtigste in Kürze
- OpenAI hat im Oktober 2026 eines der Modelle abgeschaltet, mit denen unburden Belege las. Bei einem Cloud-Modell entscheidet der Anbieter, wie lange es das Modell gibt, und jeder Beleg landet bei ihm.
- Wir haben Qwen3-VL-8B, ein offenes Modell, mit echten und Tausenden erfundenen Belegen trainiert. Wir besitzen die Modelldateien und können das Modell bei einem Anbieter unserer Wahl oder auf einem eigenen Server betreiben.
- Der entscheidende Schritt: Das Modell schreibt nur ab, was gedruckt ist. Gewöhnlicher Code rechnet nach und bucht nichts, was nicht aufgeht.
- Auf 180 echten Belegen liest es 96,7 % richtig und bucht keinen falsch, Claude Sonnet 5.5 liest 90,6 % richtig, GPT-6.1 Sol 88,3 %. Mit einem zweiten eigenen Modell als Zweitleser sind es 99,4 %.
Ab dem 24. Oktober 2026 konnte unser internes Spesen-Tool unburden bestimmte Belege nicht mehr buchen. Wenn jemand von uns ein Geschäftsessen mit Trinkgeld oder einen Coop-Einkauf mit zwei Steuersätzen hochlud, landete der Beleg nicht in der Buchhaltung, sondern unter «Probleme». Von OpenAI kam nur diese Meldung:
The model
o4-minihas been deprecated.
unburden haben wir für uns selbst gebaut, und bis heute buchen nur wir bei megazord.studio unsere Spesen damit. Es ist unser dritter Versuch, unsere Spesen zu automatisieren. Spendy, unsere erste Web-App von Anfang 2025, las Belege mit GPT-4 und legte sie in Bexio an, kannte aber nur Franken und einen Steuersatz pro Beleg und ordnete die Kartenzahlungen nicht zu. Ab Mai 2025 liefen die Spesen über die Bexio-Debitkarten von Amnis. Deren Synchronisation nach Bexio liess das Spesenkürzel weg, also schrieb unser Skript «Amnisnator» alle fünf Minuten Händler und Kürzel in die Buchungen. Im Herbst 2025 kamen auch Mehrwertsteuer und Notizen nicht mehr zuverlässig in Bexio an, bei SBB-Billetten ging so die Vorsteuer verloren. Wir wechselten für Spesen zu Revolut Business, das eine Schnittstelle für Ausgaben bietet. Aus dem geplanten Umbau des Amnisnator auf Revolut wurde im Dezember 2025 unburden.
Wir fotografieren einen Beleg, das Tool liest Betrag, Händler und Mehrwertsteuer, findet die passende Kartenzahlung auf dem Firmenkonto und bucht beides in Bexio. Das Aufteilen der Mehrwertsteuer hatte o4-mini übernommen, und das hatte OpenAI am 23. Oktober abgeschaltet.
Wer seine Software auf ein Cloud-Modell von OpenAI oder Anthropic baut, hängt von deren Modellangebot ab. Der Anbieter entscheidet allein, wie lange es ein Modell gibt und was es kostet. Die Frist kann kurz sein: Anthropic verspricht mindestens 60 Tage, OpenAI behält sich kürzere Fristen vor, wenn Sicherheits- oder Compliance-Gründe es verlangen. Und das Nachfolgemodell liest dieselben Anweisungen ein wenig anders. Nach jedem Wechsel beginnt das Testen von vorn.
Wohin die Belege reisen
Wo und wann jemand gegessen hat, die letzten vier Ziffern der Firmenkarte, welches Medikament in der Apotheke gekauft wurde: Mit einem Cloud-Modell geht jedes dieser Bilder an einen US-Konzern. Laut ihren eigenen Datenschutzangaben verwenden die Anbieter die Bilder nicht fürs Training und löschen sie in der Regel nach 30 Tagen; bei Verdacht auf Missbrauch oder wenn ein Gesetz es verlangt, bewahren sie sie länger auf.
Die Übermittlung ist erlaubt, aber an Bedingungen geknüpft. Weder OpenAI noch Anthropic sind unter dem Datenschutzabkommen zwischen der Schweiz und den USA zertifiziert, es braucht also zusätzliche Garantien, in der Praxis Standardvertragsklauseln. Nach dem amerikanischen CLOUD Act müssen US-Anbieter Daten auf behördliche Anordnung herausgeben, egal wo sie gespeichert sind. Ein Medikament auf dem Beleg ist ein Gesundheitsdatum und gilt als besonders schützenswert. Für Anwaltskanzleien, Arztpraxen und Banken gelten wegen des Berufs- oder Bankgeheimnisses noch strengere Anforderungen.
Wir wollten deshalb schon länger selbst bestimmen, welches Modell unsere Belege liest und wo es läuft. Ob ein kleines, selbst trainiertes Modell bei dieser einen Aufgabe mit GPT und Claude mithalten kann, wussten wir nicht.
Ein Modell, das uns gehört
Unsere Grundlage ist Qwen3-VL-8B von Alibaba, ein Modell mit offenen Gewichten. Wir können die Modelldatei herunterladen, behalten und unter der Lizenz Apache 2.0 auch kommerziell nutzen. Laufen lassen können wir sie bei jedem Anbieter, der Grafikkarten vermietet, in einem Schweizer Rechenzentrum oder auf einem eigenen Server. Wird ein Anbieter teurer oder hört er auf, zieht das Modell um. Abschalten kann es niemand.
Von Haus aus scheitert es allerdings an den Eigenheiten Schweizer Belege. Coop druckt oft zwei Steuersätze, 2,6 % für Lebensmittel und 8,1 % für den Rest, und jeder Satz braucht in der Buchhaltung einen eigenen Code. Ein Trinkgeld steht manchmal nur auf dem Kartenbeleg, der höher ist als die Rechnung. Auch die Überschrift einer MwSt-Zeile hilft nicht: Bei Coop enthält der Betrag unter «TOTAL» die Mehrwertsteuer schon, bei anderen Händlern kommt sie zum Betrag unter «Total» noch hinzu.
Wir haben das Modell deshalb mit Tausenden Beispielen samt richtiger Antwort auf die Belegerkennung trainiert. Das Verfahren heisst Fine-Tuning. Genauer: Mit LoRA trainierten wir nur einen kleinen Zusatz, der die Antworten des Modells anpasst; das Modell selbst blieb unverändert. Das braucht so wenig Speicher, dass eine einzelne Grafikkarte genügt.
Woran wir das Modell messen
Bevor wir irgendetwas trainierten, brauchten wir einen Massstab. Den hatten wir schon: Belege, die in unburden gebucht waren. Zu jedem kannten wir aus der Buchhaltung Betrag, Mehrwertsteuer und die Zahlung auf der Bank. 126 Belege von 102 verschiedenen Händlern legten wir als Testset beiseite, an dem sich jede Version messen musste. Erfundene Belege kamen dort nie hinein. Ein Test aus erfundenen Belegen würde messen, wie gut das Modell den Generator kennt, nicht wie gut es echte Belege liest.
Belege, die es nie gab
Echte Trainingsbelege hatten wir rund 270, und sie stammten von nur 31 Händlern. Ein Modell, das nur diese kennt, lernt Coop und Migros auswendig und scheitert am Bäcker um die Ecke. Also haben wir Belege erfunden.
Für einen Teil der erfundenen Belege liessen wir Bilder zeichnen. Ein Programm legt fest, was auf dem Beleg steht, und rechnet Preise und Mehrwertsteuer selbst aus. Daraus erzeugt ein Bildgenerator das Foto eines Kassenzettels. Am häufigsten verwenden wir GPT-5.6 Luna von OpenAI, das gedruckten Text fast immer Zeichen für Zeichen richtig wiedergibt, für Abwechslung auch Grok Imagine und Gemini. Danach liest Claude jedes Bild und vergleicht es mit der Vorgabe. Was nicht stimmt, fliegt raus. So entstanden unter anderem 1'200 Belege von 1'200 verschiedenen erfundenen Händlern.
Daneben variieren wir echte Belege: Wir schreiben einen ab und lassen ihn mit gleichem Aufbau, aber anderen Zahlen neu zeichnen. Und schliesslich bauen wir Belege direkt im Code, als Webseite, die wir fotografieren. Danach wird das Bild gedreht, unscharf gemacht, abgedunkelt und stark komprimiert, bis es aussieht wie ein schnell geknipstes Handyfoto. Hier stimmen die Werte immer, weil der Code sie selbst ausgerechnet hat.
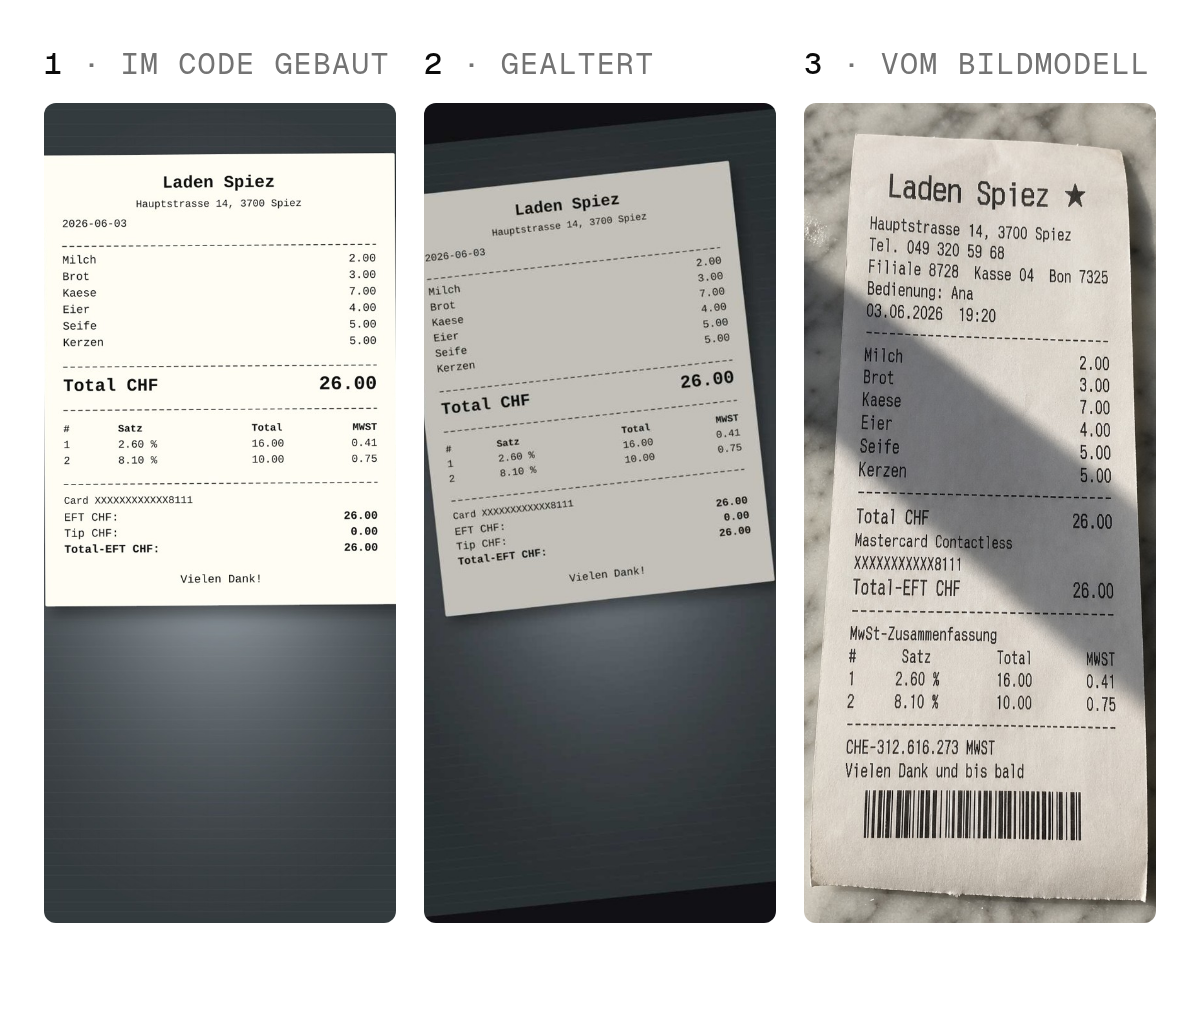
Rausfliegen musste einiges. Ab und zu ignorierte der Generator die Vorgabe und zeichnete einen englischen Musterbeleg mit «SAMPLE»-Stempel. Also schrieben wir in die Anweisung, er solle kein «SAMPLE» drucken. Bei den nächsten 24 Bildern war jedes zweite unbrauchbar, vorher jedes dreissigste. Mit dem Verbot hatten wir den Generator erst auf die Idee gebracht.
74,6 Prozent, die in Wahrheit 30,2 waren
Beim ersten Training lagen 193 von 200 Handyfotos für das Modell quer. Ein Handy speichert ein Foto oft quer und vermerkt nur in der Datei, dass man es drehen muss, und unser Trainingsprogramm hatte diesen Vermerk übersehen.
Der nächste Fehler war schwerer zu sehen. Wir trainierten zuerst nur mit erfundenen Belegen, danach mit echten. Die zweite Version las 74,6 % der Testbelege richtig und sah nach einem Durchbruch aus. In Wahrheit waren es 30,2 %. Beim Export hatten wir nur die Mehrwertsteuer von Belegen mit mehreren Steuersätzen ausgelesen, bei allen übrigen fehlte sie. So stand bei 91 % der echten Trainingsbelege «keine MwSt» und bei 82 % der Testbelege. Das Modell hatte gelernt: echtes Foto, keine Mehrwertsteuer. Und der Test gab ihm recht, weil er denselben Fehler hatte. Das untrainierte Modell las auf demselben Test mehr richtig als unsere ersten zwei Versionen.
Mit korrigiertem Export ging es aufwärts. Dann blieb es stehen. Fünf Versionen hintereinander landeten zwischen 83 und 87 %, egal wie viele Belege wir dazugaben.
Das Trinkgeld, das es nie gab
Was schieflief, verriet uns das Modell schliesslich selbst. Es sollte vor jeder Antwort kurz nachrechnen, ob seine Zahlen zusammenpassen. Unter zwei Beträge, die sich um 4.81 Franken unterschieden, schrieb es «matching», also «stimmt überein». Bei einem Beleg ganz ohne Mehrwertsteuer und ohne Trinkgeld erfand es beides: eine Steuergruppe zu 8 % und ein Trinkgeld von 7.65 Franken. Das war genau der Betrag, der fehlte, damit seine eigene Rechnung aufging.
Das Modell hatte nicht rechnen gelernt. Es hatte gelernt, eine Rechnung vorzuführen, die aufgeht.
Abschreiben statt rechnen
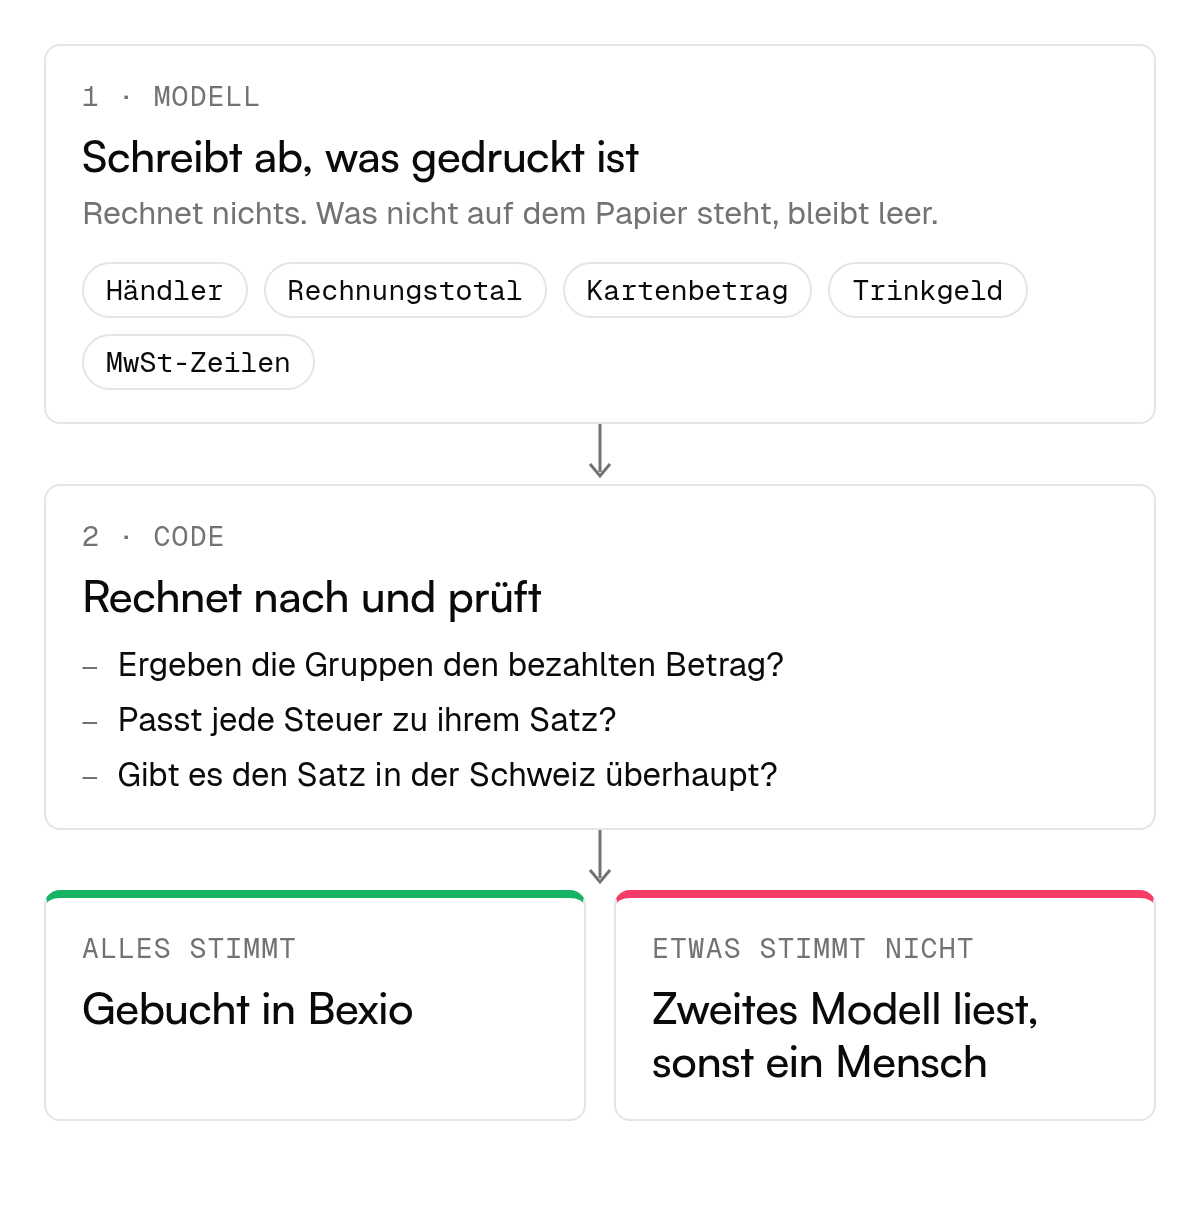
Also haben wir ihm das Rechnen weggenommen. Das Modell schreibt nur noch ab, was auf dem Papier steht, und lässt ein Feld leer, wenn dort nichts steht. Bei einem Coop-Beleg erfasst es den Händler, die Währung und die gedruckten Beträge. Die gekürzte technische Antwort sieht so aus:
{
  "merchant": "Coop",
  "currency": "CHF",
  "bill": 55.1,
  "eft": 55.1,
  "tip": null,
  "vat": [[2.6, 42.7, 1.08],
          [8.1, 12.4, 0.93]]
}
bill ist das Total der Rechnung, eft der Betrag auf dem Kartenbeleg, und vat nennt pro Steuersatz den gedruckten Betrag und die Steuer. Das Rechnen und Kontrollieren übernimmt gewöhnlicher Code. Er findet heraus, ob 42.70 netto oder brutto ist, indem er mit dem bezahlten Betrag vergleicht. Er berechnet das Trinkgeld aus dem Unterschied zwischen Kartenbeleg und Rechnung. Und er prüft, ob die Steuergruppen zusammen den bezahlten Betrag ergeben und ob die Steuerbeträge zu ihren Sätzen passen. Auch ein Steuersatz, den es in der Schweiz nicht gibt, fällt dabei auf.
Schlägt eine Kontrolle an, bucht unburden den Beleg nicht. Zuerst liest ihn ein zweites Modell, dazu weiter unten mehr. Geht auch dessen Antwort nicht auf, erscheint er unter «Probleme», zusammen mit dem Grund, warum die Zahlen nicht aufgehen. Jemand von uns schaut sich den Beleg an, korrigiert die Werte und bucht ihn dann selbst. Das kostet Zeit. Ein falsch gebuchter Beleg kostet mehr, denn er steht unbemerkt in der Buchhaltung, bis ihn jemand findet.
Beim Beleg eines Tee- und Gewürzladens hielt das Modell zum Beispiel die Summenzeile der MwSt-Tabelle für einen dritten Steuersatz: Aus der Steuersumme 28.89 wurde ein Satz von 28,89 %. Weder als netto noch als brutto gehen die Beträge dann auf die bezahlten 417.40 Franken auf. Der Code merkt das, und der Beleg landet in der Prüfung statt falsch in der Buchhaltung.
Ein Sofortsieg war der Umbau nicht. Die erste Version, die nur abschrieb, las weniger richtig als die alte und buchte 19 Belege falsch, ohne dass eine Kontrolle anschlug. Fast alles waren Abschreibfehler: eine Steuer als Trinkgeld gelesen, ein Kartenbeleg übersehen. Beim Abschreiben kamen wir mit weiterem Training voran, beim Rechnen waren wir stecken geblieben. Mit vielfältigeren Belegen, darunter die 1'200 von 1'200 Händlern, las Version 29 schliesslich 121 von 126 Testbelegen richtig, schickte fünf zur Prüfung und buchte keinen falsch. Diese Version liest heute in unburden.
Was die 180 Belege zeigen
Für den Schlussvergleich haben wir das Testset um 54 echte Belege erweitert, mit denen Version 29 weder trainiert noch ausgewählt wurde. Die 180 Belege wurden zwischen Dezember 2025 und September 2026 in unburden hochgeladen. Jedes Modell bekam dieselben Bilder und dieselbe Anweisung, und derselbe Code hat jede Antwort gebucht. Als richtig zählt ein Beleg, wenn die Buchung in Bexio stimmt: Total, Währung, Trinkgeld und jede Steuergruppe mit Betrag und Satz. «Zur Prüfung» heisst: Der Beleg wäre nicht automatisch gebucht worden, sondern bei uns unter «Probleme» gelandet. Das gilt auch, wenn das Total nicht zum Betrag auf der Bank passt, weil unburden den Beleg dann keiner Zahlung zuordnet. Datum und Händler haben wir nicht bewertet.
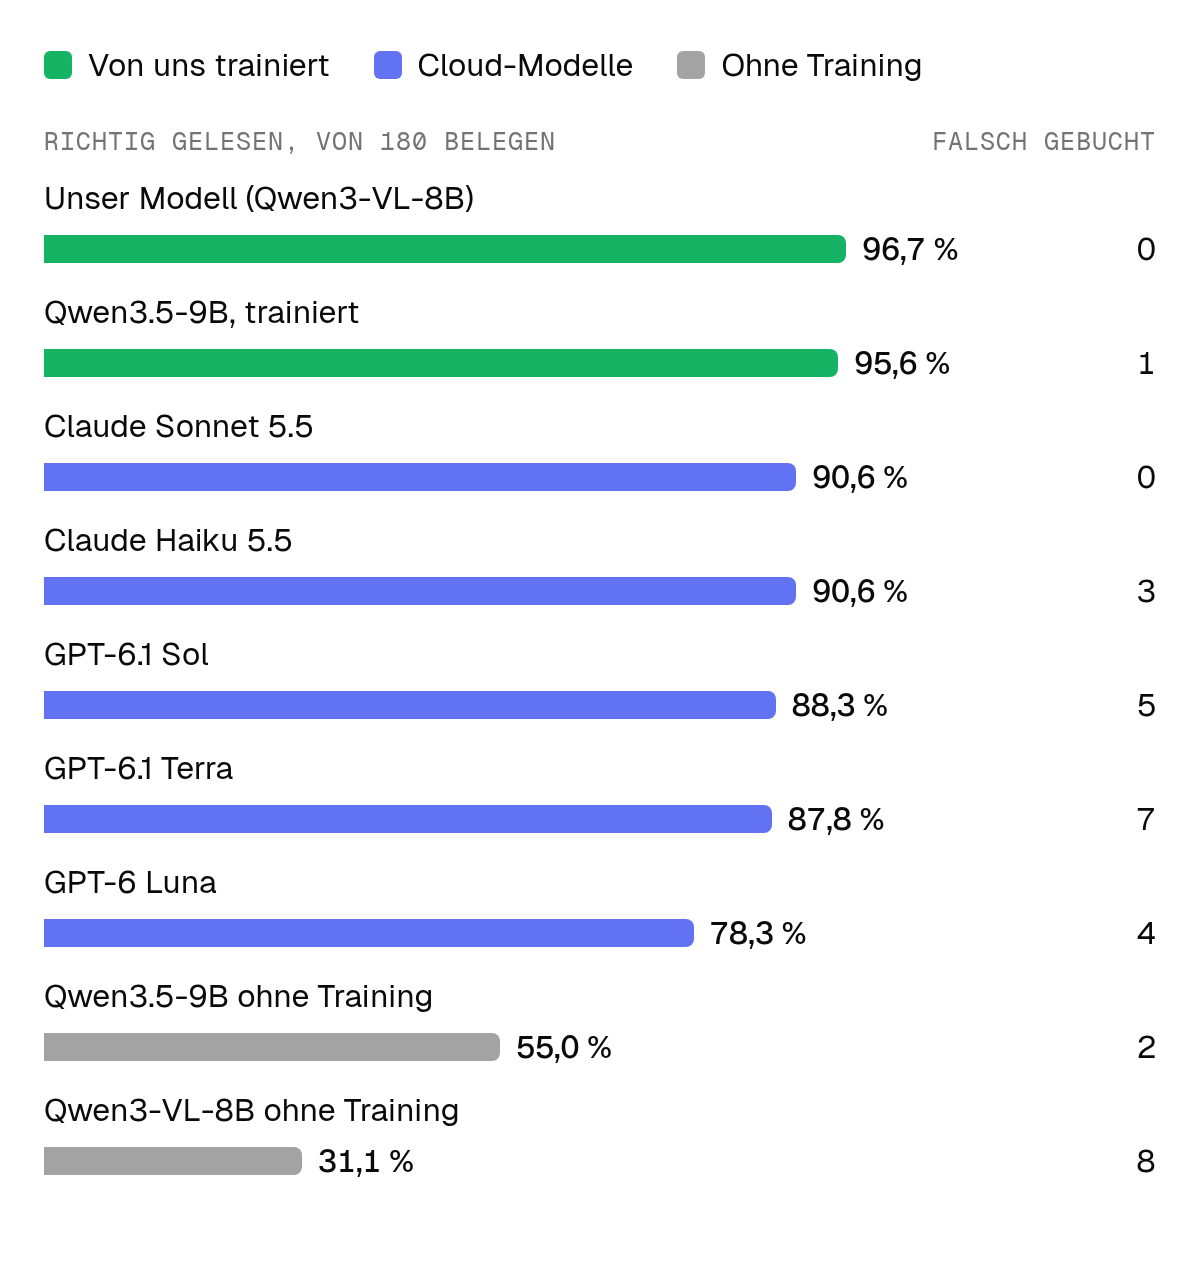
| Modell | richtig | Prüfung | falsch |
|---|---|---|---|
| Unser Modell (Qwen3-VL-8B) | 96,7 % | 3,3 % | 0,0 % |
| Qwen3.5-9B, trainiert | 95,6 % | 3,9 % | 0,6 % |
| Claude Sonnet 5.5 | 90,6 % | 9,4 % | 0,0 % |
| Claude Haiku 5.5 | 90,6 % | 7,8 % | 1,7 % |
| GPT-6.1 Sol | 88,3 % | 8,9 % | 2,8 % |
| GPT-6.1 Terra | 87,8 % | 8,3 % | 3,9 % |
| GPT-6 Luna | 78,3 % | 19,4 % | 2,2 % |
| Qwen3.5-9B ohne Training | 55,0 % | 43,9 % | 1,1 % |
| Qwen3-VL-8B ohne Training | 31,1 % | 64,4 % | 4,4 % |
Unser Modell liest elf Belege mehr richtig als Sonnet und schickt sechs statt siebzehn zur Prüfung. Falsch gebucht haben beide keinen, die GPT-Modelle vier bis sieben. Am aussagekräftigsten sind die 54 Belege, die Version 29 weder im Training noch bei der Auswahl gesehen hat: Dort las unser Modell 53 richtig, Sonnet, GPT-6.1 Sol und GPT-6.1 Terra je 50, Haiku 48 und GPT-6 Luna 44.
Das Abschreiben hilft auch den grossen Modellen. Mit der alten Logik von unburden buchte Sonnet 26 von 180 Belegen falsch, 19 davon, weil das Tool 8,1 % einsetzte, wenn kein Satz gedruckt war. Mit Abschreiben und nachrechnendem Code waren es null.
Ein zweites Modell für die schwierigen Fälle
Mit unseren Trainingsdaten haben wir auch ein zweites Modell trainiert, Qwen3.5-9B, der neueren Generation derselben Familie. Allein kam es fast gleich weit. Als wir die Fehler der beiden verglichen, sahen wir: Das erste Modell scheiterte an sechs Belegen, das zweite an acht. Nur einen lasen beide nicht richtig.
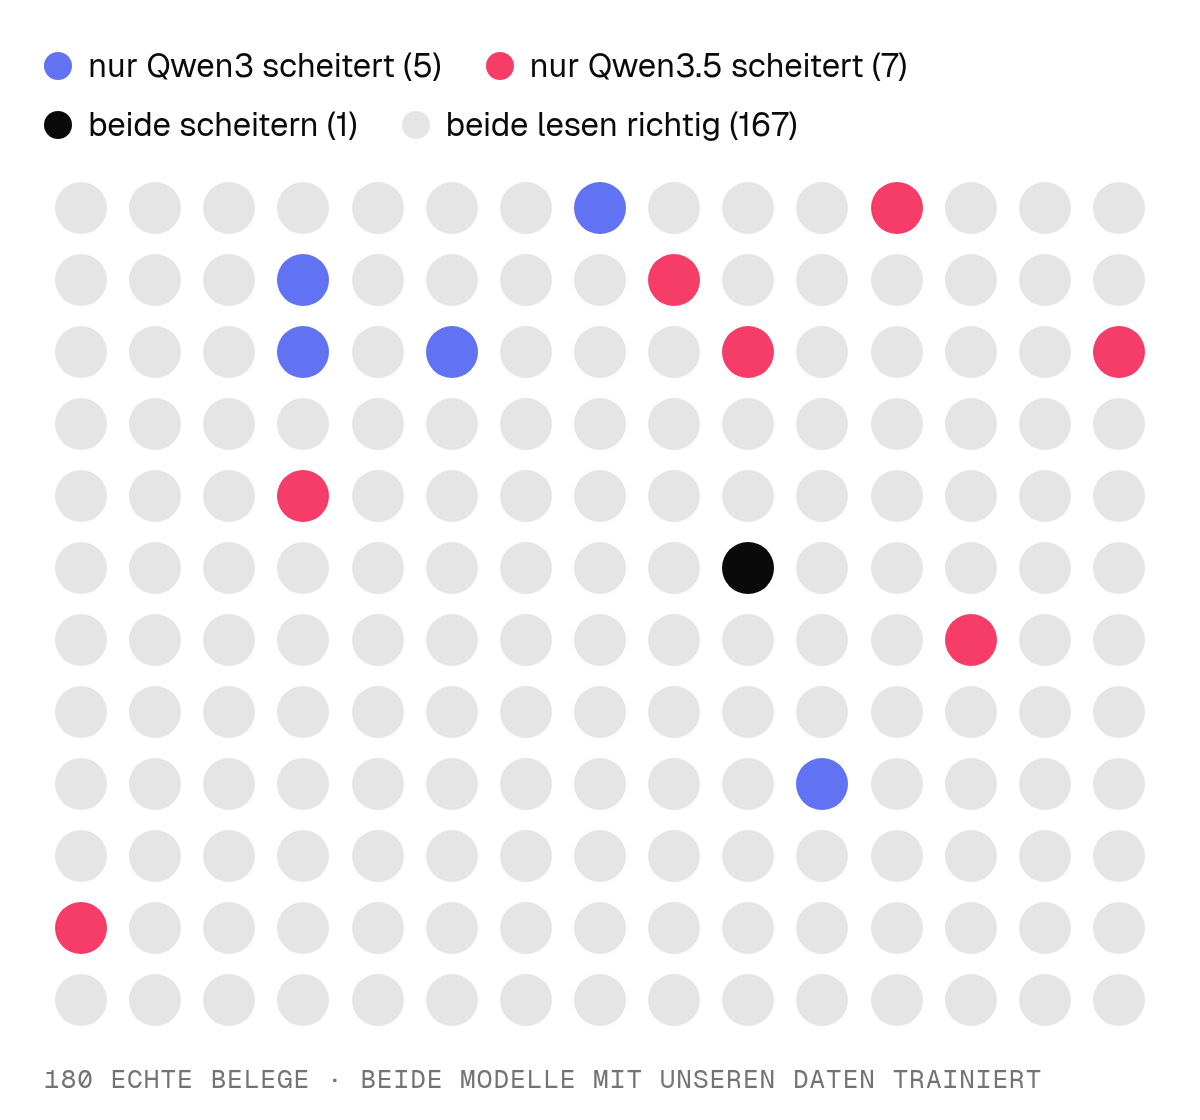
So läuft es auch in unburden: Das zweite Modell liest nur die Belege, bei denen beim ersten eine Kontrolle angeschlagen hat, und seine Antwort übernehmen wir nur, wenn sie alle Kontrollen besteht. Fachleute nennen das eine Kaskade. Zusammen lasen die beiden 179 von 180 Belegen richtig, 99,4 %. Mit Claude Sonnet als Zweitleser wären es 98,9 % gewesen.
Wie das Modell heute läuft
In unburden läuft unser Modell auf einer gemieteten Grafikkarte, für rund 0,7 Rappen pro Beleg. Ohne Grafikkarte dauert ein Beleg 4 bis 20 Minuten. Haiku wäre mit rund 0,06 Rappen pro Beleg günstiger. Bei 50 Belegen im Monat kostet die Grafikkarte rund 35 Rappen, Haiku rund 3 Rappen.
Claude Sonnet liest einen Beleg nur noch, wenn auch Qwen3.5 unsicher ist oder die Grafikkarte nicht antwortet. Im Test hätte Claude von den 180 Belegen einen einzigen lesen müssen. Rechnungen liest vorerst ebenfalls Claude, für sie haben wir noch kein eigenes Modell. Diese Dokumente gehen also weiterhin an einen Cloud-Anbieter, und auch Anthropic schaltet Modelle ab, mit mindestens 60 Tagen Vorlauf.
Fünf Dinge, die wir wieder so machen würden
- Zuerst den Test bauen, dann das Modell. Ein paar Hundert echte Dokumente mit bekannter richtiger Antwort, die nie ins Training gehen. Und die richtigen Antworten im Test genauso prüfen wie die Trainingsdaten: Unser erster Test hatte denselben Exportfehler und bestätigte die falschen 74,6 %.
- Das Modell abschreiben lassen, den Code rechnen. Was sich nachrechnen lässt, gehört in den Code. Eine Antwort, die nicht aufgeht, wird nicht gebucht, sondern einem Menschen vorgelegt.
- Trainingsdaten im Code erzeugen, wo es geht. Ein Beleg, den ein Programm baut, hat immer die richtigen Werte. Bilder aus einem Generator erst nach einer Kontrolle verwenden, und dem Generator beschreiben, was er zeichnen soll, statt was er weglassen soll.
- Vielfalt vor Menge. 1'200 Belege von 1'200 Händlern halfen mehr als Tausende von denselben wenigen Läden.
- Zwei verschiedene Modelle kombinieren. Sie scheitern an verschiedenen Dokumenten. Das zweite liest nur die schwierigen Fälle und kostet entsprechend wenig.
The model has been deprecated.
Diese Meldung wird unser Belegmodell nie zurückgeben. Die Gewichte liegen bei uns.
Ihr KI-Projekt mit megazord.studio
unburden ist nicht unser einziges KI-Projekt. Mit Evaluno haben wir ein System gebaut, das Marktinformationen selbstständig findet, analysiert und strukturiert aufbereitet. Im Marktmonitoring arbeiten wir mit Scrappy, einer KI-gestützten Recherche-Pipeline, die Anbieter, Produkte und Preise aus dem Web in strukturierte Daten übersetzt. Sprachmodelle betreiben wir auch komplett offline im eigenen Cluster.
Daneben entwickeln wir digitale Produkte und die Plattformen, auf denen sie laufen, aus einer Hand. So haben wir an der hybriden On-Premise-Plattform der SBB mitgebaut, für Agroscope eine Datenplattform entwickelt und für die nationale Patientenbefragung Swiss PREMs ein Versandsystem gebaut, das Kontakt- und Befragungsdaten konsequent trennt. Dieses Wissen über sichere Plattformen, saubere Daten und Datenschutz steckt auch in unseren KI-Lösungen. Für Ihr KI-Vorhaben bringen wir mit:
- KI, die ein Problem löst. Wir setzen KI dort ein, wo sie messbar etwas bringt: Dokumente lesen und verbuchen, internes Wissen durchsuchbar machen, Anfragen und Fälle vorbereiten.
- Das passende Modell. Ein Cloud-Modell, wenn es passt, ein eigenes, auf einem frei verfügbaren Grundmodell trainiertes Modell, wenn Datenschutz, Kosten oder Abhängigkeit dagegen sprechen. Entschieden wird nach einem Test mit Ihren echten Daten.
- Betrieb dort, wo Ihre Daten bleiben müssen. Auf Ihrer eigenen Infrastruktur, in einem Schweizer Rechenzentrum oder in unserem eigenen Cluster. Datenschutz und Berufsgeheimnis sind von Anfang an Teil der Architektur.
- Von der Idee bis zum Betrieb. In einem Design Sprint von ein bis zwei Wochen wird aus einem diffusen KI-Thema ein klarer Anwendungsfall. In wenigen Wochen folgt ein erstes Produkt, das echte Nutzerinnen und Nutzer testen, und danach der Weg in den produktiven Betrieb.
- KI im Team verankern. In Workshops zu AI Adoption bringen wir Ihrem Team bei, KI im Arbeitsalltag sicher und produktiv einzusetzen, zugeschnitten auf Ihre Werkzeuge, Daten und Vorgaben.
Erzählen Sie uns, was Sie vorhaben. Im ersten Gespräch klären wir, wo KI bei Ihnen wirklich etwas bringt und ob dafür ein Cloud-Modell genügt oder ein eigenes Modell besser ist. Projekt besprechen →
Ein KI-Vorhaben im Kopf? Wir begleiten es von der Idee über die Entwicklung bis zum Betrieb, auf Wunsch ganz in Ihrer eigenen Infrastruktur.